Представьте, что вы заказываете одно и то же блюдо в трех разных ресторанах одной сети. В первом вам приносят идеальную пасту, во втором — пересоленную, а в третьем — вообще макароны с кетчупом. Вы в недоумении: рецепт-то один! Примерно так же чувствует себя команда разработки, когда приложение отлично работает на компьютере программиста, но падает в тестовой среде или, что еще хуже, на боевом сервере.
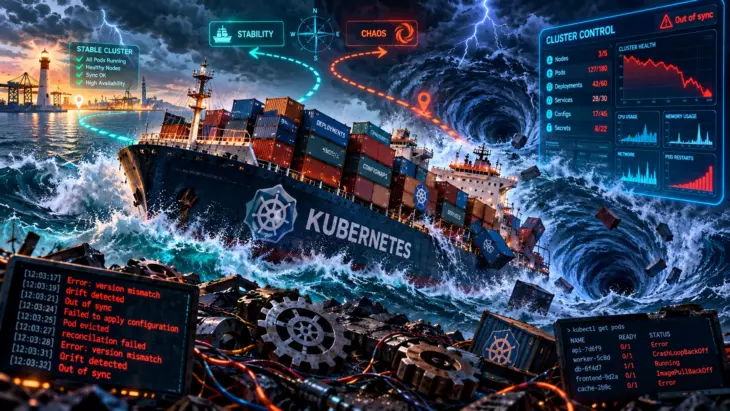
Kubernetes (K8s) — это мощный инструмент, который должен был навести порядок в запуске приложений. Но на практике он часто превращается в источник хаоса. Почему так происходит и как это исправить, разберемся простыми словами.
- Эффект «сломанного телефона» в ваших конфигурациях
- Helm-чарты: благо, которое стало проклятием
- Почему CI/CD пайплайны ломаются именно на деплое
- Снежинки: уникальные серверы как произведение искусства
- Философия Immutable Infrastructure: ничего не чиним, а заменяем
- GitOps: единый источник правды
- Практические шаги: как сделать, чтобы «работало одинаково везде»
- 1. Единый репозиторий для конфигураций
- 2. Фиксируйте версии всего
- 3. Запретите ручной доступ к боевому кластеру
- 4. Начните с малого
- Заключение
- FAQ: Частые вопросы
Эффект «сломанного телефона» в ваших конфигурациях
Kubernetes работает по принципу «все описано в файлах». Вы пишете инструкции: сколько копий приложения запустить, сколько памяти ему выдать, куда подключаться. Это удобно, но здесь кроется ловушка.
Эти файлы-инструкции живут своей жизнью в разных местах: у разработчика на ноутбуке, в тестовом кластере, на проде. Со временем они начинают отличаться. Где-то поправили настройку «на скорую руку», чтобы починить срочный баг. Где-то забыли обновить версию. В итоге у вас есть не одна система, а три разные, которые только притворяются одинаковыми.
Ручные правки на боевом сервере — это мина замедленного действия. Сегодня вы поправили одну цифру и забыли, а через месяц это ломает деплой у всего отдела.
Helm-чарты: благо, которое стало проклятием
Для управления инструкциями часто используют Helm — это как «менеджер пакетов» для Kubernetes. Чарт — это шаблон с настройками по умолчанию, куда вы подставляете свои значения. Звучит здорово, но есть нюанс.
Версии чартов обновляются постоянно. Команда А использует версию 1.2, команда Б — 2.0, а в документации описана вообще 1.5. Когда вы пытаетесь обновить приложение, выясняется, что параметры в новых версиях называются по-другому или работают иначе. Это приводит к знаменитой ошибке: «На моей машине все работает, а в проде пайплайн красный».
Почему CI/CD пайплайны ломаются именно на деплое
CI/CD — это конвейер, который автоматически собирает ваш код и доставляет его на серверы. Многие думают, что если код собрался, то проблема решена. Но на самом деле самое интересное начинается после.
Вот типичный сценарий:
- Программист написал код и проверил его в своей мини-среде (она часто сильно урезана).
- Код уехал в тестовый кластер, где конфигураций уже чуть-чуть, но другие.
- Приложение попыталось стартовать, но не нашло нужного ключа доступа или базы данных, потому что в проде они называются иначе или лежат в другом месте.
- Пайплайн падает. Все бегут выяснять, кто виноват.
Корень зла не в самом коде, а в том, что окружения отличаются. Код ожидает одну реальность, а на сервере его встречает другая.
Снежинки: уникальные серверы как произведение искусства
В среде системных администраторов есть понятие «сервер-снежинка». Это машина, которая настолько уникальна и неповторима в своих ручных настройках, что повторить ее конфигурацию невозможно. Если такой сервер упадет, поднять его заново будет очень сложно.
Kubernetes был призван убить «снежинок», но на практике люди перенесли ту же привычку. Ручные команды, выполненные прямо в кластере, исправления «на живую» создают новый вид снежинок — теперь не на уровне железа, а на уровне оркестрации.
Интересно, что даже опытные инженеры иногда не помнят, какие именно ручные изменения вносили в кластер месяц назад. А Kubernetes, в отличие от человека, не забывает: все эти «патчи» накапливаются и создают непредсказуемое поведение.
Философия Immutable Infrastructure: ничего не чиним, а заменяем
В традиционном подходе, когда сервер ломается, вы заходите на него и чините. Это как латать старые джинсы заплатками — работает до поры до времени. Концепция Immutable Infrastructure (неизменяемая инфраструктура) предлагает другой путь: если что-то сломалось или требует обновления, мы не чиним это, а выбрасываем и создаем новое с нуля по шаблону.
Это радикально меняет мышление:
- Запрещено заходить на сервер и править файлы вручную.
- Любое изменение — это новая версия конфигурации в репозитории кода.
- Развертывание всегда происходит из чистого листа, что гарантирует одинаковый результат.
Такой подход позволяет воспроизвести любое окружение за минуты. Если тестовая среда сломалась, вы не тратите день на ее починку, а просто создаете новую из проверенного шаблона.
GitOps: единый источник правды
GitOps — это дальнейшее развитие идеи неизменяемости. Суть проста: вся конфигурация ваших приложений и инфраструктуры хранится в Git-репозитории (как код). И Kubernetes постоянно сверяется с этим репозиторием.
Как это работает на практике:
- Вы вносите изменения не вручную в кластере, а через запрос на слияние кода (Pull Request).
- Специальный агент видит, что в Git что-то поменялось.
- Он автоматически приводит реальное состояние кластера в соответствие с тем, что написано в Git.
Если кто-то ночью вручную поменял настройку на проде, агент это заметит и автоматически откатит к тому, что записано в репозитории. Хаосу просто не оставляют шансов.
Главное преимущество GitOps — это аудит и история. Вы всегда знаете, кто, что и зачем менял, просто посмотрев историю коммитов в вашем репозитории.
Практические шаги: как сделать, чтобы «работало одинаково везде»
1. Единый репозиторий для конфигураций
Соберите все настройки окружений в одном месте. Разработчики, тестировщики и DevOps-инженеры должны видеть одну и ту же картину. Разница между dev и prod должна быть минимальной и явной: обычно это касается адресов баз данных или количества реплик, но не архитектуры. Так реализуются современные платформы управления циклом контейнеров с приложениями.
2. Фиксируйте версии всего
Не используйте плавающие теги типа «latest» в продакшене. Каждая зависимость, каждый образ контейнера должны иметь жесткую привязку к версии. Это касается и Helm-чартов. Лучше обновляться медленнее, но предсказуемо.
3. Запретите ручной доступ к боевому кластеру
Доступ к проду по SSH или через консоль должен быть ограничен. Все изменения — только через пайплайн. Если что-то сломалось, пайплайн должен это показать, а не инженер, который копается в логах на сервере.
4. Начните с малого
Не пытайтесь перевести всю инфраструктуру на GitOps за один день. Начните с одного некритичного сервиса. Опишите его конфигурацию в Git, убедитесь, что она воспроизводится автоматически. Затем масштабируйте подход.
Частая ошибка новичков — пытаться внедрить все инструменты сразу. Выбирайте один, изучите его досконально и только потом добавляйте следующий.
Заключение
Непредсказуемость в Kubernetes — это не свойство самой технологии, а следствие наших привычек. Мы привыкли чинить вручную, держать конфигурации в головах, а не в коде, и мириться с тем, что окружения «немного отличаются».
Переход к неизменяемой инфраструктуре и GitOps — это смена культуры. Когда все описано кодом, когда развертывание всегда идет из одного источника, предсказуемость возвращается. Ваше приложение ведет себя одинаково что в понедельник утром на проде, что в пятницу вечером на стенде разработки. И это именно то спокойствие, ради которого стоило затевать весь этот Kubernetes.
FAQ: Частые вопросы
Почему Kubernetes непредсказуем при деплое?
Основная причина — расхождение между средами. Конфигурации тестового и боевого кластеров со временем начинают отличаться из-за ручных правок, разных версий Helm-чартов и отсутствия единого источника правды. Код, написанный для одной среды, сталкивается с неожиданными условиями в другой, что приводит к падениям на этапе деплоя.
Что такое дрейф конфигураций в Kubernetes?
Дрейф конфигураций — это процесс постепенного расхождения между тем, как система описана в документации или в репозитории, и тем, как она реально работает в кластере. Обычно возникает из-за ручных исправлений на сервере, из которых никто не записал. Со временем такое расхождение накапливается и делает поведение системы непредсказуемым, а развертывание — рискованным.
Что такое GitOps простыми словами?
GitOps — это подход к управлению инфраструктурой, при котором Git-репозиторий является единственным источником правды о том, как все должно быть настроено. Все изменения вносятся только через код в Git, а специальные инструменты автоматически приводят реальный кластер в соответствие с этим описанием. Это исключает ручной хаос и делает всю систему воспроизводимой.